· AI · 26 min read
See in the Dark 论文复现项目 —— 从零开始的机器学习/深度学习详解
目标:假设你完全没有深度学习基础,机器学习也只记得"拟合关系""聚类"这种模糊印象。这篇文档会把知识从底往上搭:先讲传统机器学习,再讲深度学习,最后把这两块知识对应到你老师这个项目的每一个模块上。
目标:假设你完全没有深度学习基础,机器学习也只记得”拟合关系""聚类”这种模糊印象。这篇文档会把知识从底往上搭:先讲传统机器学习,再讲深度学习,最后把这两块知识对应到你老师这个项目的每一个模块上。
第一部分:机器学习到底在干什么
1.1 机器学习的本质:从数据里”拟合”一个函数
你说的”用各种函数各种方法去得到线性关系”其实抓住了核心。机器学习的本质就是:
给定输入 x,找到一个函数 f,使得 f(x) 尽可能接近真实答案 y。
区别只在于:
- x 和 y 是什么(图像?数字?类别?)
- f 长什么样(一条直线?一棵树?一个神经网络?)
- 怎么衡量”接近”(用什么损失函数)
- 怎么找到这个 f(用什么优化算法)
1.2 三大类问题
(1) 回归(Regression)—— 预测一个连续数值
- 例子:根据房屋面积预测房价
- 最简单形式:线性回归
y = wx + b,本质是找一条直线(或超平面)尽量穿过所有数据点 - “几种预测形式”你提到的,大概率就是:线性回归、多项式回归、逻辑回归(虽然叫回归但其实做分类)
(2) 分类(Classification)—— 预测一个类别
- 例子:这张图是猫还是狗?这封邮件是不是垃圾邮件?
- 常见方法:逻辑回归、决策树、支持向量机(SVM)、K近邻(KNN)
- 这个项目本质上就是”分类”问题的像素级版本:判断每一个像素是”文字”还是”背景”,这叫语义分割(Semantic Segmentation)——可以理解成”对图像里的每个像素做一次二分类”。
(3) 聚类(Clustering)—— 没有标签,自己找规律
- 你说的”聚簇”就是这个。K-means、层次聚类、DBSCAN 都属于此类
- 核心思想:把相似的数据点自动分到同一组,不需要人先告诉它答案
- 这个项目不涉及聚类,因为训练数据是有标签的(人工标注了文字区域),属于监督学习(Supervised Learning),不是无监督学习。
1.3 监督学习的通用套路(这是理解一切的关键框架)
不管是线性回归还是最复杂的深度神经网络,监督学习都是同一个流程:
1. 准备数据:一堆 (输入 x, 正确答案 y) 的样本对
2. 定义模型:一个带有可调参数的函数 f_θ(x),θ 是参数(比如直线的斜率 w、截距 b)
3. 定义损失函数:衡量 f_θ(x) 和真实 y 差多少,比如均方误差 (y-ŷ)²
4. 优化:不断调整 θ,让损失函数变小 —— 这一步几乎总是用"梯度下降"
5. 评估:在没见过的数据上测试模型好不好,防止"死记硬背"(过拟合)
这五步你要背下来,因为后面深度学习、这个论文项目,全部都是这个套路的复杂版本,只是第2步的”函数”换成了神经网络。
1.4 几个绕不开的概念
| 概念 | 通俗解释 |
|---|---|
| 过拟合 (Overfitting) | 模型把训练数据”背”下来了,但换一批新数据就表现很差,像死记硬背例题却不会举一反三 |
| 欠拟合 (Underfitting) | 模型太简单,连训练数据都学不好 |
| 训练集/验证集/测试集 | 训练集用来学,验证集用来调参,测试集用来最终打分(三者不能混用,否则”作弊”) |
| 梯度下降 (Gradient Descent) | 想象站在山坡上蒙着眼睛找山谷最低点,每一步都往”当前最陡的下坡方向”走一点,这个”方向”就是梯度的反方向 |
| 学习率 (Learning Rate) | 每一步走多大。太大容易跨过谷底来回震荡,太小收敛太慢 |
第二部分:深度学习是什么(在机器学习的基础上升级)
2.1 神经网络:把”一条直线”换成”很多层直线+非线性弯折”
线性回归只能拟合直线关系。现实世界的关系是弯弯曲曲的(比如”图像里哪部分是文字”根本不是线性可分的问题)。深度学习的做法是:
输入 → 线性变换(加权求和) → 非线性激活函数(弯折) → 线性变换 → 非线性 → ... → 输出每一层”线性变换 + 非线性激活”叠加起来,理论上可以拟合任意复杂的函数。这就是”深度”(多层)神经网络的由来。
- 线性变换:跟线性回归的
wx+b一模一样,只是这里 w 是一个矩阵 - 非线性激活函数:比如 ReLU(负数变0,正数不变)、Sigmoid(把任意数压缩到0~1之间)。没有这一步,无论叠多少层,本质上还是一条”直线”(矩阵乘法的叠加还是线性变换)
2.2 反向传播:神经网络怎么”学”
神经网络的参数(权重)可能有几百万个,怎么找到让损失最小的那组参数?
答案还是梯度下降,只是因为网络有很多层,要用一个叫**反向传播(Backpropagation)**的技巧,利用”链式法则”从输出层往输入层,一层一层算出每个参数该往哪个方向调、调多少。你不需要手推公式,但要知道:
训练一个神经网络 = 不断做”前向计算预测 → 算损失 → 反向传播算梯度 → 更新参数”这个循环,直到损失足够小。
这个循环里的每一轮,通常叫一个 iteration(迭代/step);把整个训练集过一遍叫一个 epoch;每次不是拿全部数据算梯度,而是拿一小批,叫 batch(批次)。
2.3 卷积神经网络(CNN):专门处理图像的神经网络
图像是像素网格,如果每个像素都单独接一个权重(像普通神经网络那样),参数量会爆炸,而且忽略了”空间局部性”(相邻像素往往相关)。CNN 用一个叫**卷积核(kernel/filter)**的小窗口在图像上滑动,每个位置做加权求和,这样:
- 参数量大大减少(同一个卷积核在整张图上共享)
- 能自动学习到”边缘""纹理""形状”这类局部特征
- 多层卷积叠加后,网络能从”低级特征(边缘)“逐渐组合出”高级特征(物体轮廓、文字形状)”
卷积核的尺寸(比如 3×3、1×5、5×1)决定了它”看”多大范围、什么形状的局部区域——这个概念你在后面 DSF 模块会用到,先记住。
2.4 编码器-解码器结构(Encoder-Decoder):这个项目的核心骨架
图像分割任务需要:输入一张图,输出一张同样大小的图(每个像素标”是文字/不是文字”)。直接用普通 CNN 会让图像越卷越小(分辨率降低),没法输出和原图一样大的结果。于是常用结构是:
编码器 (Encoder):不断下采样,图像越来越小、通道越来越多 → 提取"这张图里有什么"的抽象特征
                    ↓
解码器 (Decoder):不断上采样,把抽象特征还原回原图大小 → 决定"每个位置具体是不是文字"
可以类比:编码器像是”先眯着眼看全局,看出大概哪里有文字的轮廓”;解码器像是”再睁大眼睛,把每个像素精确标出来”。
2.5 二分类分割的损失函数:BCEWithLogitsLoss
每个像素只有两种可能:文字 / 背景,这是二分类问题。常用损失函数是二元交叉熵(Binary Cross Entropy, BCE):
BCE = -[y·log(p) + (1-y)·log(1-p)]- y 是真实标签(0或1)
- p 是模型预测”是文字”的概率
- 如果真实是文字(y=1)但模型预测概率p很低,log(p)是很大的负数,损失就很大——即”预测错得越离谱,惩罚越重”
BCEWithLogitsLoss 是 PyTorch 里的一个函数,它把”Sigmoid(把网络输出压缩到0~1)“和”BCE 损失”合并在一起算,数值上更稳定。你在仓库代码里看到这个词,就是”计算每个像素预测对不对”的核心损失。
第三部分:这个项目(see-in-the-dark)到底在做什么
3.1 一句话总结
输入一张光线很暗、看不清的图片,输出一张”哪里是文字”的黑白图(白=文字,黑=背景)。
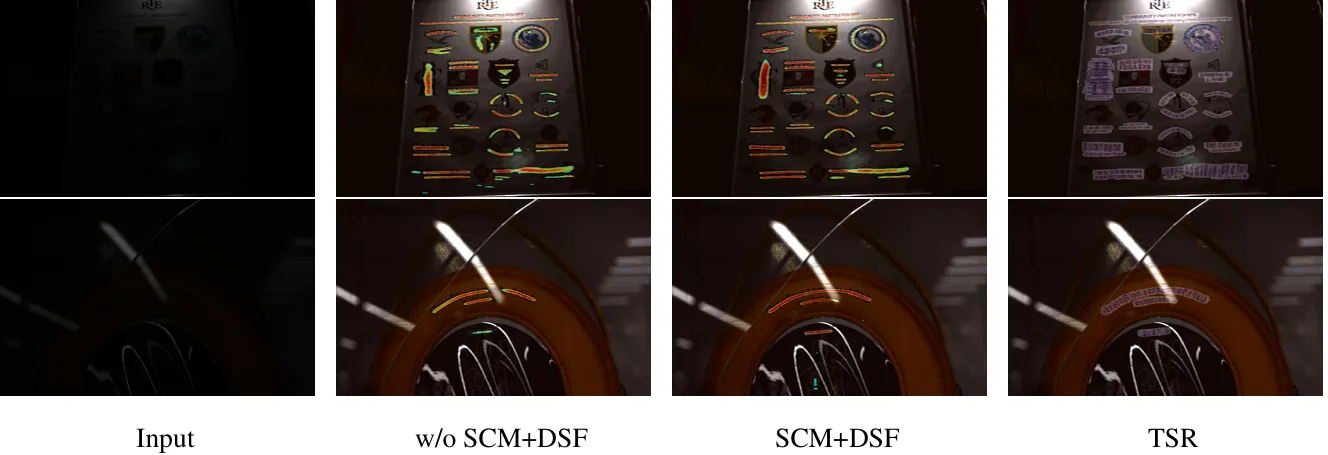
这属于低照度场景下的文本分割(Text Segmentation in Low-Light Conditions),是”语义分割”这个大类任务在特殊场景下的应用。
3.2 为什么低照场景特别难(论文的出发点)
仓库 README 直接点出了低照文本分割比普通场景难在哪:
- 光照弱,前景(文字)和背景对比度低,人眼/模型都难分辨边界
- 文字笔画细长,容易在暗处”断裂”,模型容易漏检
- 噪声、反光、阴影容易被误判成文字
- 文字可能是弯曲、多方向的,普通的正方形卷积核不一定能很好地捕捉这种细长、有方向性的结构
这四条其实对应了论文提出的几个改进模块想解决的问题,下面逐个拆。
3.3 基线模型(Baseline):先有一个能跑的分割网络
在加任何”论文创新点”之前,先要有一个稳定可训练的基础模型,这里用的是一个小型编码器-解码器分割网络(对应你在第二部分学的 Encoder-Decoder 概念):
- 编码端:从暗图像里提特征
- 解码端:把特征还原到原图分辨率
- 输出:一个和原图一样大小的 mask(每个像素预测是否是文字)
- 损失:
BCEWithLogitsLoss(对应上面讲的 BCE 损失,逐像素判断对错)
知识点对应: 这一整块就是”深度学习第2.4、2.5节”的具体落地。
3.4 模块一:SCM(辅助监督与语义一致性)
要解决的问题:只靠最后一层输出去反向传播,网络中间层的特征可能”学得不够稳”,尤其在低照场景下,特征容易发散、不可靠。
做法(在编码器提取的特征上,额外接一个”辅助分支”):
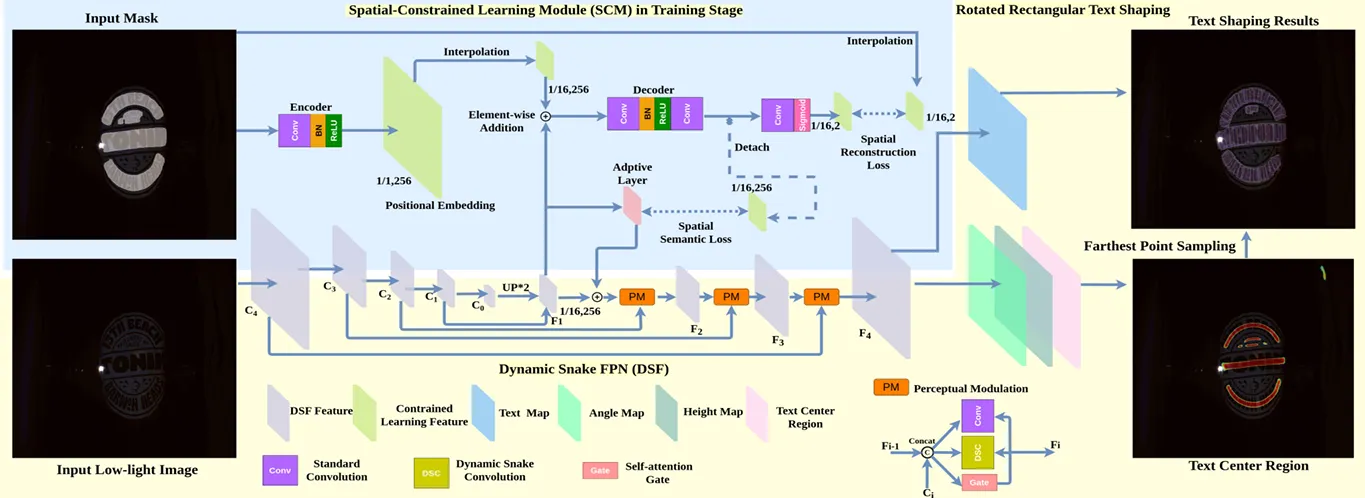
- 辅助分支单独预测一次 mask(
aux_logits),并直接用真实标签监督它 —— 这部分损失叫Lsr(可以理解成”给中间层也留一次作业和标准答案对答案”) - 同时约束辅助分支的预测概率图,要和主分支的预测尽量一致 —— 这部分损失叫
Lss(“两个分支不能自说自话,得达成共识”)
类比:就像一个学生做题,除了最后交的答案,老师还要求他把”中间演算步骤”也写出来批改(Lsr),并且要求”中间步骤的思路”不能和”最终答案的思路”自相矛盾(Lss)。这样中间过程更稳,最终答案也更可靠。
知识点对应:这是”多任务学习/深度监督(Deep Supervision)“思想的应用——给神经网络中间层也加损失函数,而不是只监督最后输出。这是深度学习里一个常见的训练技巧,能缓解梯度传播到浅层时”信号变弱”的问题(某种程度上也和你可能听过的”梯度消失”问题相关)。
3.5 模块二:DSF(方向敏感特征建模)
要解决的问题:文字是细长、有方向的(横的、竖的、弯的),标准的正方形卷积核(比如3×3)对这种细长结构不一定敏感。
做法(DSFBlock,两条支路并行处理,再融合):
- 支路A:普通
3×3卷积——保留常规局部纹理特征(对应你在2.3节学的标准卷积) - 支路B:
(1×5)卷积接(5×1)卷积的组合——这是一种”横着扫一遍、竖着扫一遍”的非对称卷积,专门增强对细长、有方向性结构的感知(想象一把很窄很长的尺子,比正方形的图章更容易”贴合”文字笔画的走向) - 融合:用 softmax gate(一种可学习的加权方式)动态决定两条支路的特征各占多少权重,而不是写死的固定比例
知识点对应:
- 非对称卷积核(1×5 + 5×1)是 CNN 里的常见变体,用小计算量近似模拟”看得更长更细”的感受野
- softmax 门控(gating)是”注意力机制(Attention)“思想的简化版本——让网络自己学会该更信任哪部分特征,而不是人为固定权重
3.6 模块三:TSR(文本结构约束与几何塑形)
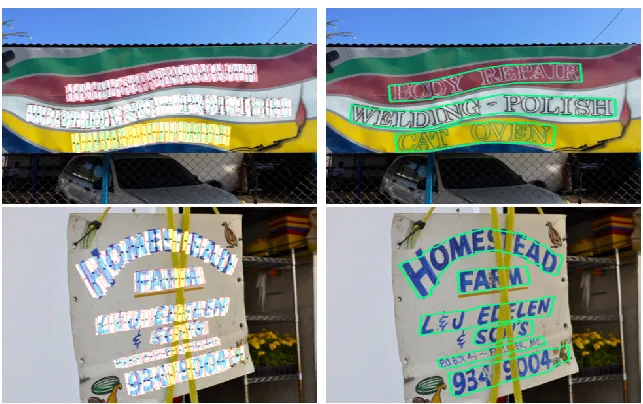
要解决的问题:分割只回答”是不是文字”还不够,相邻文字容易”粘”在一起分不开;而且最终想要的往往不是一堆散乱像素,而是规整的文字框。
做法(分训练阶段和可视化/后处理阶段):
- 训练阶段:额外让网络预测一个”文字中心区域”(
center_logits),也就是不只学”文字边界在哪”,还学”文字最中心、最确定的核心区域在哪”。这能帮助把相邻两块文字的边界撑开、避免粘连(因为中心区域更容易保持独立、不会互相粘连) - 后处理阶段(不参与训练,是推理后处理):对模型输出的二值预测做”最小外接旋转矩形”计算——用几何方法把一堆散点/像素块,包成一个规规矩矩的(可能是斜的)矩形框,更接近人眼理解的”一个文字框”
知识点对应:
- “中心区域监督”是文本检测领域常见技巧(比如你如果之后深入会遇到 PSENet、DBNet 等论文都有类似”文字核心区域”的设计思想)
- “最小外接旋转矩形”是纯几何算法(OpenCV 里的
minAreaRect之类),不属于深度学习范畴,是深度学习输出之后的传统图像处理后处理步骤——这提醒你:一个完整的视觉系统,不是全靠神经网络,很多时候前处理/后处理仍然要用传统算法。
3.7 损失函数是怎么组合起来的
仓库里目前真正实现的总损失是三部分相加:
总损失 = 主分割损失(Lseg) + SCM辅助损失(Lsr + Lss) + TSR中心监督损失(w_tsr_center × center_loss)Lseg:主分支输出 vs 真实mask 的 BCE 损失(对应3.3节基线)Lsr + Lss:SCM模块的两个损失(对应3.4节)w_tsr_center × center_loss:TSR中心区域监督损失,前面乘了一个权重系数(这是深度学习里常见的”多任务损失加权”技巧——不同任务的损失量级可能不一样,需要人为设置权重让它们别互相压制)
注意(仓库作者原话):README 里明确说明,早期设想的更完整损失组合、几何回归项,目前代码里并没有完整实现,当前更准确的定位是”论文的启发式轻量复现”,不是”论文全量复现”。这是做研究/复现项目时很重要的诚实态度,你汇报的时候也应该照实说明这一点,而不是假装完全复现了论文。
3.8 代码结构和它们分别对应上面哪块知识
src/see_in_the_dark/
├── datasets.py   → 数据集解析 + DataLoader(对应机器学习流程"第1步:准备数据")
├── models.py     → TinySegNet(基线网络) + DSF + QAT 相关模型定义(对应3.3、3.6节的网络结构定义)
├── train.py      → 训练循环 + 损失计算(对应2.2节"前向→算损失→反向传播→更新参数"的具体实现)
├── eval.py       → 可视化输出 + 训练产物保存(对应机器学习流程"第5步:评估")
└── main.py       → 读取YAML配置,组装完整训练流程(把上面几个模块串起来跑)
数据格式细节:训练用的是 CTW1500 数据集(一个专门标注了”弯曲文字”的公开数据集),按 PaddleOCR 的格式组织,每一行标注是 图片路径 + 一串多边形坐标点(points),代表这块区域是不是文字(transcription: 0 大概率表示”忽略/不关心具体文字内容,只关心区域”,因为这是分割任务不是识别任务)。
第四部分:一张表,把所有知识点串起来
| 项目里的东西 | 属于哪块知识 | 你该去补的概念 |
|---|---|---|
| ”低照文本分割”任务定义 | 计算机视觉任务分类 | 语义分割 vs 目标检测 vs 图像分类 的区别 |
| 编码器-解码器基线网络 | 深度学习-CNN架构 | Encoder-Decoder、U-Net(这是最经典的同类结构,建议专门搜一下) |
| BCEWithLogitsLoss | 深度学习-损失函数 | 交叉熵、Sigmoid、二分类 vs 多分类损失的区别 |
| SCM (Lsr + Lss) | 深度学习-训练技巧 | 深度监督(Deep Supervision)、多任务学习(Multi-task Learning) |
| DSF (1×5+5×1 卷积, softmax gate) | 深度学习-CNN变体+注意力机制 | 非对称卷积、感受野(Receptive Field)、注意力机制/门控机制入门 |
| TSR (center_logits + 最小外接矩形) | 深度学习+传统图像处理 | 文本检测常见范式(如DBNet思想)、OpenCV几何后处理 |
| 训练循环/epoch/batch/学习率 | 机器学习通用流程 | 梯度下降、反向传播、优化器(如Adam) |
| YAML配置驱动多组实验 | 工程实践(非算法本身) | 消融实验(Ablation Study)的意义——每次只改一个变量,看它对结果的影响 |
| QAT(仓库提到”已实现但默认关闭”) | 模型部署优化 | 量化感知训练(Quantization-Aware Training),是让模型在边缘设备/低算力设备上跑得更快的技术,属于”模型压缩”范畴,和分割算法本身关系不大,是工程优化 |
第五部分:如果要跟老师/答辩汇报,建议的讲述顺序
- 问题定义:低照场景文本分割为什么难(对比度低、断裂、噪声、方向多变)
- 基线方案:一个标准的 Encoder-Decoder 分割网络能做到什么程度、有什么局限
- 三个改进点分别解决什么局限:
- SCM → 解决”训练不稳、特征发散”
- DSF → 解决”卷积核形状不适应细长方向性文字”
- TSR → 解决”文字粘连、输出不规整”
- 诚实说明当前复现边界:哪些论文的完整设计还没实现(几何回归、标准检测评估指标 IoU/F1/Hmean 等),这属于”下一步工作”
- 跑通流程演示:数据格式 → 配置选择 → 训练 → 产物(loss曲线、预测可视化图)
这个顺序本质上就是”机器学习五步法”(准备数据→定义模型→定义损失→优化→评估)在这个具体项目上的展开,你如果讲得清楚这个映射关系,会显得逻辑非常清晰。
建议的后续学习路径(如果时间允许)
- 先搞懂 U-Net(最经典的编码器-解码器分割网络,10分钟科普视频/文章即可入门),这个项目的基线本质是它的简化版
- 搞懂交叉熵损失的直觉(不需要死记公式,理解”预测越离谱惩罚越大”即可)
- 了解注意力机制/门控的直觉(DSF模块里的softmax gate就是简化版),这是现代深度学习几乎无处不在的技巧
- 如果还有余力,搜一下 DBNet / PSENet(文本检测领域的经典论文),会发现TSR模块的”中心区域监督”思路和它们一脉相承,这样你就能说清楚”老师的论文站在什么已有工作基础上做了什么”