· AI · 41 min read
机器学习 & 深度学习完整知识大纲 + 论文《Seeing Text in the Dark》详解
本文包含机器学习与深度学习的完整知识地图,以及针对论文《Seeing Text in the Dark》的逐节深度解析,帮助读者建立从基础理论到前沿论文的知识体系。
说明:你上传的是论文原文(Chengpei Xu 等,Seeing Text in the Dark: Algorithm and Benchmark,arXiv 2404.08965)。这和你老师仓库
see-in-the-dark的关系是:仓库是这篇论文核心思想的”轻量复现/简化实现”(用小型分割网络近似论文里的完整检测器)。这份文档分两部分:第一部分是机器学习/深度学习的完整知识地图(大纲),第二部分是这篇论文本身的逐节详解,并在关键处标注”对应大纲第几节”,方便你把知识串起来。
第一部分:机器学习 & 深度学习知识大纲
1. 机器学习的总框架
机器学习
├── 监督学习 (Supervised Learning)  —— 有标签数据
│   ├── 回归 (Regression):预测连续值
│   └── 分类 (Classification):预测离散类别
├── 无监督学习 (Unsupervised Learning) —— 无标签数据
│   ├── 聚类 (Clustering)
│   ├── 降维 (Dimensionality Reduction)
│   └── 密度估计/异常检测
├── 自监督学习 (Self-Supervised Learning) —— 用数据自身构造"伪标签"
├── 半监督学习 (Semi-Supervised Learning) —— 少量标签+大量无标签
└── 强化学习 (Reinforcement Learning) —— 通过与环境交互、奖励信号学习策略
论文里提到的 MTM (Masked Text Modeling) 是”自监督预训练”的例子(遮住一部分让模型自己猜,类似完形填空);这篇论文本身的主体方法是监督学习。
2. 监督学习通用五步法(贯穿全文的核心框架)
- 数据:输入 x(一般化)+ 标签 y(人工标注的正确答案)
- 模型:一个带参数 θ 的函数 f_θ(x),从简单(线性回归)到复杂(深度神经网络)
- 损失函数:衡量预测和真实值差多少
- 优化算法:调整 θ 使损失变小(核心是梯度下降)
- 评估:在没见过的数据上验证泛化能力
3. 回归模型(预测连续值)
| 方法 | 核心思想 |
|---|---|
| 线性回归 | y = w·x + b,用最小二乘法找一条直线/超平面 |
| 多项式回归 | 引入 x², x³ 等高次项,拟合曲线关系 |
| 岭回归/Lasso | 在线性回归损失上加正则项,防止过拟合、让权重更稀疏 |
| 逻辑回归 (Logistic Regression) | 名字带”回归”但实际做二分类:用 Sigmoid 函数把线性输出压缩到 0~1 之间,表示”属于某类的概率” |
4. 分类模型(预测离散类别)
| 方法 | 核心思想 |
|---|---|
| 逻辑回归 | 见上,是分类里最简单的线性模型 |
| K近邻 (KNN) | “看看离你最近的K个点大多数是什么类别,你就是什么类别” |
| 决策树 | 一连串”如果…那么…”的判断规则,像做问答树 |
| 随机森林 | 很多棵决策树”投票”决定结果,降低单棵树的过拟合风险 |
| 支持向量机 (SVM) | 找一个”间隔最大”的分界线/分界面,让两类样本离分界线尽量远 |
| 朴素贝叶斯 | 基于贝叶斯公式和”特征独立”假设计算类别概率 |
| 神经网络分类器 | 见第6节 |
这篇论文做的”文本检测”本质上是像素级/区域级的分类问题:判断图像里每个位置是不是文字、文字的边界在哪——只是它比”一张图属于哪一类”复杂得多,因为要同时定位+分类。
5. 无监督学习:聚类与降维(你提到”忘了的聚簇”)
| 方法 | 核心思想 |
|---|---|
| K-means | 随机选K个中心点,把每个数据点分给最近的中心,再更新中心位置,反复迭代直到稳定 |
| 层次聚类 (Hierarchical) | 自底向上不断合并最相近的簇,形成一棵”聚类树” |
| DBSCAN | 基于密度:一个区域点足够密集就算一个簇,能自动识别不规则形状的簇、排除离群点 |
| 高斯混合模型 (GMM) | 假设数据由多个高斯分布叠加而成,用概率的方式做”软聚类” |
| PCA (主成分分析) | 降维方法,找到数据”方差最大”的几个方向,把高维数据压缩到低维还尽量保留信息 |
这篇论文不涉及聚类——它是纯监督学习任务,不需要自动”发现”分组。
6. 从传统机器学习到深度学习:为什么要用神经网络
传统机器学习方法(KNN、SVM、决策树等)通常需要人工设计”特征”(比如边缘、颜色直方图),再喂给模型。深度学习的核心突破是:让神经网络自己从原始像素中学习特征,不需要人工设计。
6.1 神经网络的基本单元
输出 = 激活函数( 权重 · 输入 + 偏置 )- 权重(weight)/偏置(bias):可学习参数,等价于线性回归里的 w 和 b
- 激活函数:引入非线性,常见的有 ReLU(负数置0)、Sigmoid(压缩到0~1)、Softmax(把一组数变成加起来等于1的概率分布,多分类常用)
多层这样的单元堆叠起来,就是”深度”神经网络(Deep Neural Network)。
6.2 反向传播与优化器
- 前向传播:输入经过每一层计算,得到预测输出
- 损失函数:比较预测和真实标签
- 反向传播 (Backpropagation):利用链式法则,从输出层往回一层层计算每个参数对损失的”贡献”(梯度)
- 优化器:根据梯度更新参数。最基础是梯度下降(SGD),论文里用的 Adam 是更聪明的版本,会自适应调整每个参数的更新步长,收敛更快更稳
6.3 卷积神经网络 (CNN):图像专用
- 卷积核 (kernel/filter):一个小窗口(如 3×3)在图像上滑动,做加权求和,提取局部特征(边缘、纹理)
- 感受野 (Receptive Field):网络某个位置的输出”看到”了原图多大范围——层数越多、卷积核越大,感受野越大
- 下采样 (Downsampling/Pooling/Stride):逐步缩小特征图尺寸,让网络看到更大范围、抽象层次更高的特征
- 主干网络 (Backbone):负责特征提取的核心网络,比如论文用的 ResNet50(一种带”残差连接”、可以堆很深层数还不容易训练失败的经典CNN架构)
6.4 特征金字塔网络 (FPN):多尺度特征融合
物体大小不一——小字和大字、小物体和大物体。FPN 的思路是把CNN不同深度的特征图(浅层分辨率高但语义弱、深层分辨率低但语义强)上下融合,让每个尺度都同时具备”看得清位置”和”懂语义”的能力。论文里的 DSF (Dynamic Snake FPN) 就是在标准FPN基础上的改造版本。
6.5 注意力机制 / 自注意力 (Self-Attention)
核心思想:不是所有输入信息都同等重要,网络应该自己学会”该更关注哪部分”。自注意力的经典公式(也是论文DSF模块里用到的):
Attention(Q, K, V) = softmax( Q·K^T / √d_k ) · V直觉解释:
- Q (Query,查询):我想找什么信息
- K (Key,键):每个位置能提供什么信息的”标签”
- V (Value,值):每个位置实际的内容
Q·K^T算出”查询”和每个”键”的相似度,softmax把相似度变成加起来等于1的权重,再用这些权重对 V 做加权求和——即”越相关的位置,权重越大,贡献越多”
这是 Transformer(当前几乎所有大模型的基础架构)的核心组件,论文里用了一个简化版(自注意力门控)来决定两种卷积特征各占多少比重。
6.6 编码器-解码器结构 (Encoder-Decoder)
- 编码器:不断下采样,压缩出”这张图有什么”的抽象特征
- 解码器:不断上采样,把抽象特征还原到原图分辨率,给出逐像素/逐位置的具体预测
这是几乎所有分割、检测网络的骨架结构(经典代表:U-Net)。
7. 深度学习的训练技巧
| 技巧 | 作用 |
|---|---|
| 数据增强 (Data Augmentation) | 对训练图像做裁剪、翻转、旋转、加噪声、调色等,人为扩充数据多样性、提升泛化能力(论文里明确用了这些) |
| 预训练 + 微调 (Pretrain + Fine-tune) | 先在大规模通用数据上训练一遍,再在目标任务的数据上”精调”,比从零训练收敛更快、效果更好(论文先在SynthText上预训练,再在MLT上微调) |
| 深度监督 (Deep Supervision) | 不止监督最终输出,也给网络中间层加损失函数,帮助训练更稳定(对应论文SCM模块的核心思想) |
| 多任务学习 (Multi-task Learning) | 一个网络同时学习多个相关任务(比如同时预测文字区域+文字中心+文字朝向),共享特征、互相促进 |
| 学习率衰减 (LR Decay) | 训练过程中逐渐减小学习率,让模型在后期”精细调整”而不是大步震荡(论文每100个epoch让学习率乘以0.1) |
| 正则化/过拟合防治 | Dropout、权重衰减(weight decay)、数据增强等,防止模型死记硬背训练数据 |
8. 损失函数大全(论文里几乎全部用到)
| 损失函数 | 用途 | 直觉 |
|---|---|---|
| 交叉熵损失 (Cross-Entropy) | 分类问题(含逐像素分类) | 预测概率离真实类别越远,惩罚指数级增大 |
| L1 损失 (绝对值误差) | 回归问题,对异常值不那么敏感 | |预测-真实| |
| L2 损失 (均方误差) | 回归问题 | (预测-真实)²,对大误差惩罚更重 |
| Smooth L1 损失 | 目标检测里常用,L1和L2的折中 | 误差小时像L2(平滑),误差大时像L1(不爆炸) |
论文式(7)的总损失:L_t = L_seg + L_H + L_θ + L_ss + L_sr,分别是交叉熵(分割)、Smooth L1(高度、角度回归)、L2(语义一致性)、L1(空间重建)——是典型的”多任务损失加权组合”。
9. 计算机视觉任务体系(定位这篇论文的位置)
计算机视觉任务
├── 图像分类 (Classification):整张图属于哪一类
├── 目标检测 (Object Detection):框出物体位置+类别(矩形框)
├── 语义分割 (Semantic Segmentation):逐像素分类,不区分个体
├── 实例分割 (Instance Segmentation):逐像素分类 + 区分个体
└── 场景文字检测 (Scene Text Detection) ← 这篇论文所在的子领域
    ├── Top-down(自上而下):先框出整体轮廓/区域,再细化(如用曲线函数、Bezier曲线描边)
    └── Bottom-up(自下而上):先找文字的小片段/组件,再把它们拼接、聚合成完整文字(论文采用此路线)
低照度场景文字检测 (Low-Light Scene Text Detection) 是”场景文字检测”在”暗光退化图像”这一恶劣条件下的细分方向,也是这篇论文的具体研究问题。
10. 模型评估指标(论文实验部分会用到)
- Precision (P,精确率):模型预测”是文字”的里面,有多少真的是文字(宁缺毋滥的程度)
- Recall (R,召回率):真实的文字里面,模型找出了多少(有没有漏检)
- F1-score:P和R的调和平均,综合衡量,
F1 = 2PR/(P+R) - IoU (Intersection over Union,交并比):预测区域和真实区域的重叠程度,判断检测框”准不准”的基础指标
- FPS (Frames Per Second):每秒能处理多少张图,衡量速度/效率
第二部分:论文《Seeing Text in the Dark: Algorithm and Benchmark》详解
0. 论文基本信息
- 作者团队来自新南威尔士大学(UNSW)、大连理工大学、悉尼科技大学(UTS)、皇家墨尔本理工大学(RMIT)
- 发表于 arXiv,2024年4月(cs.CV,计算机视觉方向)
- 核心贡献两块:一个新方法(低照度文字检测算法)+ 一个新数据集(LATeD)
1. 研究问题:为什么低照度文字检测很难
论文开篇点明现有做法的问题:“增强后再检测”(enhance-first, detect-later)的两阶段流程是直觉上最简单的方案——先用低照度图像增强(LLE, Low-Light Enhancement)算法把图片变亮变清楚,再套用现成的文字检测器。
但论文指出这个思路有根本缺陷:
- LLE 方法是为了让图片”人眼看着舒服”而设计的(论文原话强调 LLE 是 tailored for better visual effect for human vision),不是为了让下游的检测算法看得更准
- 这种”美化”过程可能在调整亮度/色彩时,无意中破坏了对检测算法真正有用的文字特征
- 于是产生误差累积:增强步骤的失真 + 检测步骤本身的误差,两个误差叠加,导致最终检测效果反而更差
论文的核心主张:跳出”先增强、后检测”的两阶段范式,设计一个不需要任何图像增强预处理的单阶段(one-stage)检测器,直接在暗光图像上把文字检测做好。
2. 相关工作定位(对应大纲第9节)
论文把已有的文字检测方法分成两大类(这和大纲里的分类完全对应):
- Top-down(自上而下)方法:直接或渐进地画出文字整体轮廓(比如用贝塞尔曲线 ABCNet、傅里叶曲线 FCENet)。问题是需要很大的感受野和全局信息,在暗光下细节丢失严重时表现受限
- Bottom-up(自下而上)方法:先识别文字的局部组件,再把它们拼接成完整文字。更能容忍局部信息缺失,但通常需要复杂的后处理(比如NMS非极大值抑制)来去除冗余候选框
论文选择 bottom-up 路线,因为它对”暗光导致信息不完整”这个问题天然更鲁棒(不需要一次性看清全局,可以从局部碎片拼出结果)。
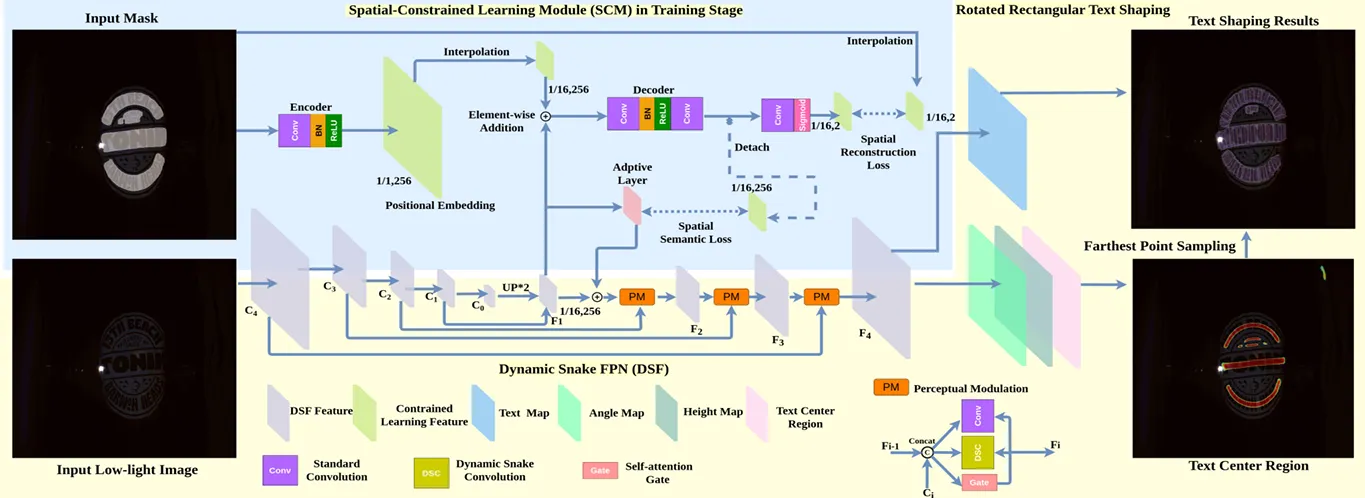
3. 方法整体架构(对应论文 Figure 2)
论文方法由三大部分组成,环环相扣:
输入暗光图像
   ↓
[基础文字检测器 Base Detector](ResNet50 主干 + 常规FPN骨架)
   ↓
[SCM 空间约束学习模块](只在训练阶段用,帮助保留空间信息)
   ↓
[DSF 动态蛇形特征金字塔](替换普通FPN,增强对文字细长走向的感知)
   ↓
输出:文字区域图(text map) + 文字中心区域图(text center region) + 旋转矩形几何参数(x,y,h,w,θ)
   ↓
[TSR 旋转矩形累积塑形](后处理,生成最终文字轮廓)
3.1 基础检测器的数学表达(对应论文式1)
min_θ L_t( Ψ(u; θ) )意思是:给定观测图像 u,检测器 Ψ 带着可学习参数 θ,目标是找到一组 θ,让训练损失 L_t 最小——这就是大纲第2节”监督学习五步法”里”步骤4:优化”的数学写法,你现在应该能看懂这个公式在说什么了。
论文指出:低照度环境下,特征图在网络中不断下采样(缩小尺寸)时,文字的空间位置信息(在哪、多大范围)容易丢失或被错误捕捉,这是导致误检、漏检的根本原因。
4. SCM:空间约束学习模块 (Spatial-Constrained Learning Module)
4.1 双层优化的表达(对应论文式2)
min_θ  L_t( Ψ(u; θ(ϑ*)) )
s.t. ϑ* = argmin_ϑ L_s( Φ(u; ϑ(θ)) )通俗翻译:主检测器 Ψ 的参数 θ 依赖于一个”辅助学习模块” Φ 的最优参数 ϑ*;而 ϑ* 又是通过让辅助模块自己的损失 L_s 最小得到的。这是一个”内外两层嵌套优化”的写法(双层优化,bi-level optimization),实践中并不需要真的严格求解两层嵌套,而是训练时把主分支损失和辅助分支损失加在一起同时优化(这就是大纲第7节”深度监督”技巧的具体数学表达)。
SCM 从两个层面设计空间约束:
4.2 空间重建约束 (Spatial Reconstruction Constraint, L_sr)
做法:
- 用标注信息(ground truth)构造一个”文字位置掩码 (text position mask)”
- 把网络输出的特征图(图2里的 C₀)上采样,和”位置编码 (positional embedding)“做逐元素相加融合
- 融合后的特征送入一个专门设计的解码器,尝试重建出与真实位置掩码对齐的结果
- 用这个重建结果和真实位置掩码的差异,构造损失 L_sr(论文里是 L1 损失)
直觉:这相当于给网络加了一道”额外的自测题”——不仅要在最后输出层预测对文字位置,还要求网络在中间特征层就能”重建”出文字的空间位置信息,逼着网络在特征压缩(下采样)过程中不要把位置信息丢了。
4.3 空间语义约束 (Spatial Semantic Constraint, L_ss)
做法:让主网络分支和SCM辅助分支在”空间重建之后的语义特征”上保持一致,用 L2损失 衡量两者的差异。
直觉:L_sr 解决的是”位置信息别丢”,L_ss 解决的是”两个分支的理解不要互相矛盾”——辅助分支产生的语义特征图能提供文字的上下文范围信息,L_ss 把这个信息”传导”给主分支,弥合两个分支之间的语义鸿沟,让主分支在暗光和正常光照条件下都能更聚焦文字区域。
对应大纲:SCM 整体就是”深度监督 + 多任务学习”思想(大纲第7节)的具体工程实现,而 L_sr、L_ss 分别是 L1、L2 损失(大纲第8节)的实际应用场景。
5. Bottom-up 文字拓扑建模
5.1 DSF:动态蛇形特征金字塔 (Dynamic Snake FPN)
出发点:文字的形状特点是”沿中心线延展的细长分布,笔画向不同弯曲方向发散”——标准的正方形卷积核(比如3×3)不太适合捕捉这种细长、弯曲的拓扑结构。
核心组件:动态蛇形卷积 (Dynamic Snake Convolution, DSC)——这是论文引用的另一篇已有工作(Qi et al., CVPR 2023),专门为”管状/细长结构分割”设计(原本用于医学图像里血管这类细长结构的分割)。论文把它引入文字检测领域,因为文字笔画的细长特性和血管有相似之处。
DSF结构(论文式3-5,即”感知调制模块 Perceptual Modulation Block”):
X_i = concat(C_i, F_{i-1})                                     式(3)
V = concat( Conv(X_i), DSC(X_i) )                               式(4)
F_i = softmax( σ(W_Q·V+b_Q)(σ(W_K·V+b_K))^T / √d_k ) · V        式(5)
逐步翻译:
- 式(3):把当前层的特征图 C_i 和上一层的输出 F_{i-1} 拼接起来,得到 X_i(跨层信息融合,类似FPN”自上而下”路径)
- 式(4):对 X_i 分别做”普通卷积 Conv”和”动态蛇形卷积 DSC”,把两条支路的结果拼接成 V——这正是大纲6.4节讲的”两条支路并行处理、再融合”的思想,一条管常规局部纹理,一条管细长走向特征
- 式(5):这就是大纲6.5节讲的自注意力公式,只是 Q、K、V 都来自同一个 V(自注意力门控),网络自己学习该给”常规卷积特征”和”蛇形卷积特征”分别多少权重,而不是人为写死的固定比例
为什么叫”感知调制”:它不是简单相加两条支路,而是用自注意力机制”动态调制”两者的融合比例——在文字弯曲复杂的地方可能更依赖蛇形卷积,在文字平直规整的地方可能更依赖常规卷积。
5.2 TSR:旋转矩形累积文字塑形 (Text Shaping with Rotated Rectangular Accumulation)
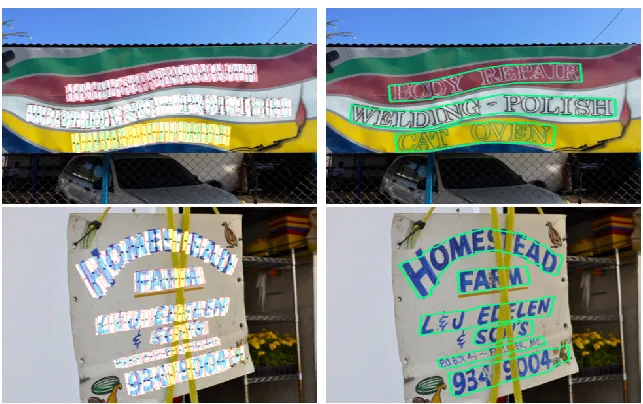
背景思路:DSF处理完之后,网络最终输出两张关键特征图:文字区域图(text map) 和 文字中心区域图(text center region map),同时还会回归出每个候选文字组件的几何参数 (x, y, h, w, θ)——即矩形中心坐标、高度、宽度、旋转角度。
核心比喻(论文原话,“积分”思想):把计算一块面积的问题,转化成”很多个小矩形块累加起来”的问题(类似微积分里用小矩形逼近曲线下面积)。论文把这个思想搬到文字轮廓建模上:用很多个小的旋转矩形,沿着文字中心线一路累积排列,拼出整条文字的自然形状(宽度固定,位置和角度随文字走向变化)。
候选点太多怎么办——最远点采样 (Farthest Point Sampling, FPS):
文字中心区域掩码可能框出大量候选中心点,如果每个点都生成一个矩形,会有大量冗余重叠。已有的 bottom-up 方法通常用 NMS(非极大值抑制) 去重,但论文指出 NMS 的问题:
- 只看重叠程度,不考虑文字的”流线型拓扑分布特征”,可能导致选出的矩形不能连贯反映文字中心走向
- NMS 依赖随机性和参数设置,还需要大量两两重叠度计算,计算量大
论文改用 最远点采样(FPS,原本是点云处理里常用的降采样技术):每次都选一个”离已选点集合最远”的点加入结果集合,这样能在减少候选点数量的同时,尽量保留原始点集合的几何分布特征(对应论文式6):
p = argmax_{p∈P} min_{t∈T} ||p - t||_2翻译:在候选点集合 P 里,找一个点 p,使得它离”已选中心区域 T”里最近的点也尽量远——反复执行就能得到均匀分布、覆盖整条文字走向的一组代表性中心点。
最后一步——形态学闭运算 (Morphological Closing):把每个被选中的旋转矩形沿文字中心线累积起来后,用简单的形态学闭运算填补文字组件之间的小缝隙和内部小孔洞,得到最终连贯的文字轮廓。论文特别提到:即使在严重暗光退化下,SCM+DSF 生成的中心区域不够完整,TSR 依然有机会把这些破碎的区域”接”起来(对应论文 Figure 3 第3列的可视化效果)。
对应大纲:TSR 是纯粹的传统几何后处理算法(不属于神经网络训练部分),呼应了之前学习指南里提到的”深度学习输出之后仍需要传统图像处理兜底”这一点,现在你能看到具体是”最远点采样+形态学闭运算”这两个经典算法。
6. 总损失函数(对应论文式7)
L_t = L_seg + L_H + L_θ + L_ss + L_sr| 符号 | 含义 | 损失类型 |
|---|---|---|
| L_seg | 文字区域图 + 文字中心区域图的交叉熵损失之和 | 交叉熵(分类,大纲第8节) |
| L_H | 文字组件高度的回归损失 | Smooth L1(回归) |
| L_θ | 文字组件旋转角度的回归损失 | Smooth L1(回归) |
| L_ss | SCM的空间语义一致性损失 | L2 |
| L_sr | SCM的空间重建损失 | L1 |
这是典型的多任务损失组合(大纲第7节):一个网络同时要做”分类”(是不是文字)+ “回归”(矩形的高度、角度)+ “辅助一致性约束”,五项损失加权(论文这里权重都设为1,未做进一步调参说明)求和反向传播。
7. LATeD 数据集:论文的第二大贡献
论文指出已有的低照度文字检测数据集(Xue et al. 提出的数据集)问题很多:平均每张图不到2个文字、场景和文字重复度很高、用矩形标注(不够精确)、完全没有弯曲文字样本、训练测试集划分不清晰。
论文自建的 LATeD (Low-light Arbitrary-shape Text Detection) 数据集特点:
- 1,500 张图(1,000训练 + 500测试),全部是夜间人工实地拍摄(不是用软件把白天照片调暗合成的”伪造”暗光图)
- 13,923 个任意形状文字,其中 4,554 个是弯曲文字
- 多语言:以英文、中文为主,还包含日语、韩语、越南语、阿拉伯语
- 精确到行级别的多边形标注(而不是粗糙的矩形框)
- 场景多样:海报、包装、服装、广告牌、路牌、涂鸦等
- 评测标准直接沿用了知名数据集 CTW1500 的评测协议,保证可比较性、可复现性
这体现了论文标题里 “Benchmark” 这个词的含义——不仅提出算法,还提供了一套标准化的评测基准,供后续研究者公平比较。
8. 实验设置与结果详解
8.1 实现细节
- 主干网络:ResNet50
- 预训练流程:先在 SynthText(合成文字数据集)上训练2轮,再在 MLT(多语言文字数据集)上微调100轮——这是大纲7节”预训练+微调”技巧的实际应用
- 优化器:Adam,初始学习率 0.0001,每100轮衰减为原来的0.1倍(大纲7节”学习率衰减”)
- 数据增强:随机裁剪、缩放、颜色调整、加噪声、翻转、旋转(大纲7节”数据增强”)
- Batch size = 10,训练 250 epoch,单张 NVIDIA RTX A6000 GPU
8.2 四种实验设置对比(Table 2 核心结论)
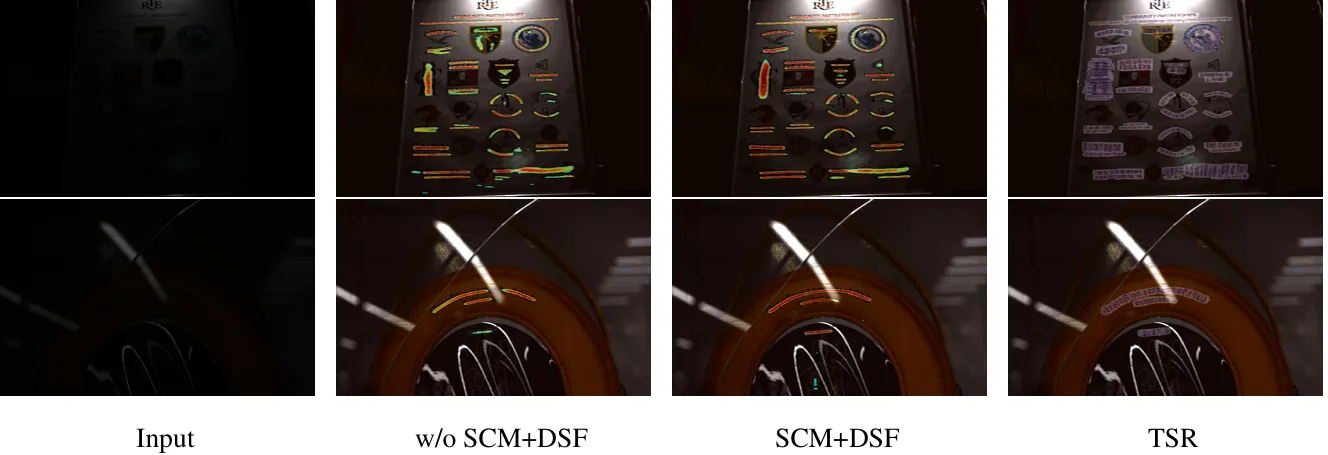
论文设计了四种对比场景,非常有说服力地论证了”为什么不该用增强后再检测”:
- Detection(直接检测):11个专为正常光照设计的检测器直接用在暗光图上——全部F1都低于50%,其中表现最好的 BPN++ 也只有 47.7%
- LLE(先增强再检测):用6种主流图像增强方法把图片调亮,再用最好的检测器(BPN++)检测——F1提升到49.5%~54.2%之间,提升有限
- FINE-TUNE(用增强图像微调检测器):不仅增强图像,还专门用增强后的图像微调检测器——F1提升到52.4%~59.8%,但仍然比不过论文方法
- FULLY-TRAINED(直接在暗光图上完整训练):论文方法在暗光原图上完整训练(不做任何增强),达到 F1 = 67.1%,全面超过所有对比方案(对比组里表现最好的 BPN++ 完整训练也只有59.5%)
这组对比直接支撑了论文摘要里的核心论点:图像增强是为人眼服务的,不一定对检测算法有利,直接在暗光图像上专门设计训练策略反而更有效。
8.3 正常光照数据集上的表现(Table 3)
论文方法不仅在暗光数据集LATeD上领先,在正常光照的标准数据集上也有竞争力甚至最优:
- CTW1500:F1 = 86.2%(超过对比方法)
- Total-Text:F1 = 88.5%,召回率(Recall) 86.6%(当时最高)
- MSRA-TD500:F1 = 87.1%(与最优方法相近)
这说明论文设计的模块不是”只针对暗光的特殊技巧”,而是能同时提升暗光和正常光照场景下文字检测能力的通用改进。
8.4 消融实验 (Ablation Study,Table 4) —— 逐个验证每个模块的贡献
消融实验的做法是:从一个”基线”(标准FPN + NMS去重的旋转矩形,不含SCM)开始,每次加一个模块,看效果提升多少。这是验证”论文提出的每个创新点是否真的有用”的标准科研方法(对应你之前问的”知识点”里,这是做研究报告/答辩时必须掌握的实验设计思路)。
在 LATeD 数据集上的关键数字:
| 配置 | F1(%) | FPS |
|---|---|---|
| 基线(无SCM/DSF/TSR) | 59.6 | 2.1 |
| + TSR | 60.4 | 10.9(速度大幅提升) |
| + SCM + TSR | 64.0 | 10.9 |
| + DSF + TSR(无SCM) | 62.3 | 10.2 |
| + SCM + DSF + TSR(完整方法) | 66.4 | 10.2 |
几个值得注意的知识点:
- 加入TSR后速度大幅提升(2.1→10.9 FPS):因为论文用”最远点采样”替代了计算量大的NMS,验证了5.2节里”FPS比NMS更高效”的设计动机
- SCM带来最大的单项F1提升(+4.4%,在CTW1500上是+1.9%):说明”空间约束学习”确实是缓解暗光下空间信息丢失问题的关键——这是论文标题里 “Algorithm” 的核心创新点
- DSF的贡献也很显著(+2.7%和+1.5%):验证了”动态蛇形卷积+自注意力融合”确实能更好捕捉文字的拓扑结构
- 三个模块叠加是1+1+1>3的组合效应:完整方法比基线提升 6.8%(LATeD)和 2.5%(CTW1500),且几乎不牺牲推理速度——这是论文强调”高效且有效(efficient and effective)“的数据支撑
9. 论文与你老师仓库的对应关系(重要)
结合你之前看到的仓库 README,可以整理出这张对照表:
| 论文完整设计 | 仓库简化实现 | 差异说明 |
|---|---|---|
| ResNet50 backbone + 完整FPN + 检测头 | TinySegNet(小型分割网络) | 仓库用一个轻量分割网络近似论文的检测器,牺牲精度换取能在笔记本GPU(RTX 4060)上跑 |
| SCM:L_sr(文字位置重建,L1)+ L_ss(语义一致性,L2) | SCM简化版:Lsr(辅助头直接监督mask)+ Lss(主辅分支概率图一致性) | 思路一致,但仓库没有实现论文里”positional embedding + 专用解码器重建”的具体机制,是更直接简化的版本 |
| DSF:DSC(动态蛇形卷积) + 常规卷积 + 自注意力门控(Q/K/V) | DSFBlock:(1×5)+(5×1)非对称卷积 + 常规3×3卷积 + softmax gate | 仓库没有使用真正的DSC(那是另一篇独立论文的复杂卷积核,能沿着任意方向自适应弯曲),而是用固定形状的横向/纵向卷积核做近似;门控机制也简化成了普通softmax而非完整自注意力(Q/K/V) |
| TSR:文字中心区域 + 旋转矩形几何回归(x,y,h,w,θ) + 最远点采样 + 旋转矩形累积 | TSR简化版:center_logits(中心区域预测) + 最小外接旋转矩形(minAreaRect) | 仓库没有实现”逐组件几何回归”和”最远点采样+累积”这套完整流程,而是用更简单的”对最终二值预测直接算一个外接矩形”来近似 |
| 完整损失:L_seg + L_H + L_θ + L_ss + L_sr(5项) | 简化损失:Lseg + Lsr + Lss + center_loss(4项,且部分不完全等价) | 仓库明确承认没有实现几何回归项(L_H, L_θ) |
| LATeD自建数据集 | 使用公开的 CTW1500 数据集 | 仓库训练用的是论文里作为”正常光照对比数据集”的CTW1500,而不是论文专门构建的暗光数据集LATeD(仓库目前也没有拿到/使用LATeD) |
这张对照表建议你在给老师汇报时重点展示:既能证明你理解了论文的完整设计,又能诚实、清晰地说明当前复现版本简化了哪些部分、为什么简化(算力限制、工程复杂度),这比”假装完全复现”更能体现你的理解深度。
10. 论文一句话总结(可用于摘要/汇报开场)
这篇论文提出了首个无需预先图像增强的单阶段暗光场景文字检测方法:通过 SCM 模块在训练时约束网络保留文字的空间位置和语义信息,通过 DSF 模块(动态蛇形卷积+自注意力融合)更好建模文字细长弯曲的拓扑结构,再用 TSR 模块(最远点采样+旋转矩形累积)以自下而上的方式重建出精确文字轮廓;同时构建了首个高质量、多语言、任意形状的暗光文字检测数据集 LATeD,在暗光和正常光照数据集上均取得了当时最优或接近最优的效果。